TER EEA | Autonomous Car
This project was carried out in 2022-2023 as part of the TER EEA at ENS Paris-Saclay with Rémi Lembeye and Amaury Ajasse.
Introduction
Le but du projet est de gagner la course de voitures autonomes Saclay. La course met en concurrence des équipes d'étudiants de différentes écoles du plateau de Saclay. Pour cela, les équipes disposent d'une base de TT02, nous sommes cependant les seuls à l'avoir fiabilisé. Les équipes sont chargées de réaliser l'électronique et l'informatique de commande de la voiture afin que celle-ci puisse suivre une piste délimitée par des bords hauts de 20cm, rouges à gauche et verts à droite. La voiture doit donc faire des tours de piste le plus rapidement possible sur un tracé inconnu à l'avance et en évitant les obstacles potentiels.
L'objectif de ce rapport est de rendre compte du travail accompli dans le cadre de ce projet en décrivant les différentes solutions mises en œuvre. Le but est ainsi de permettre une reprise des codes, CAO, et électroniques utilisés pour les futures équipes de l'ENS Paris-Saclay.
Architecture matérielle et contrôle bas-niveau
Mise en place d'une architecture mécanique et électronique optimisée ainsi que l'implémentation du code bas-niveau, puis intégration des stratégies sur le Raspberry Pi.
En premier lieu, voici les différents éléments qui composent la voiture.
- Un châssis de base TT02
- Un Raspberry Pi 4 et sa caméra V2 pour la stratégie
- Un Lidar Hokuyo UBG04-LX
- Un STM32F4 ⇒ Nucleo L432KC pour l'asservissement et la récup des capteurs
- Un mix entre les kits TT02-S01BU et TATT-S03BU de Yeah Racing
- Différents supports imprimés en 3D
- Des capteurs Sharp GP2Y0A21YK0F IR pour la marche arrière
- Un codeur magnétique AS5600 pour la mesure de vitesse
Amélioration de la base mécanique
- Le servomoteur de direction d'origine
- La direction en plastique
- Pas de supports pour l'électronique
Changement du servomoteur
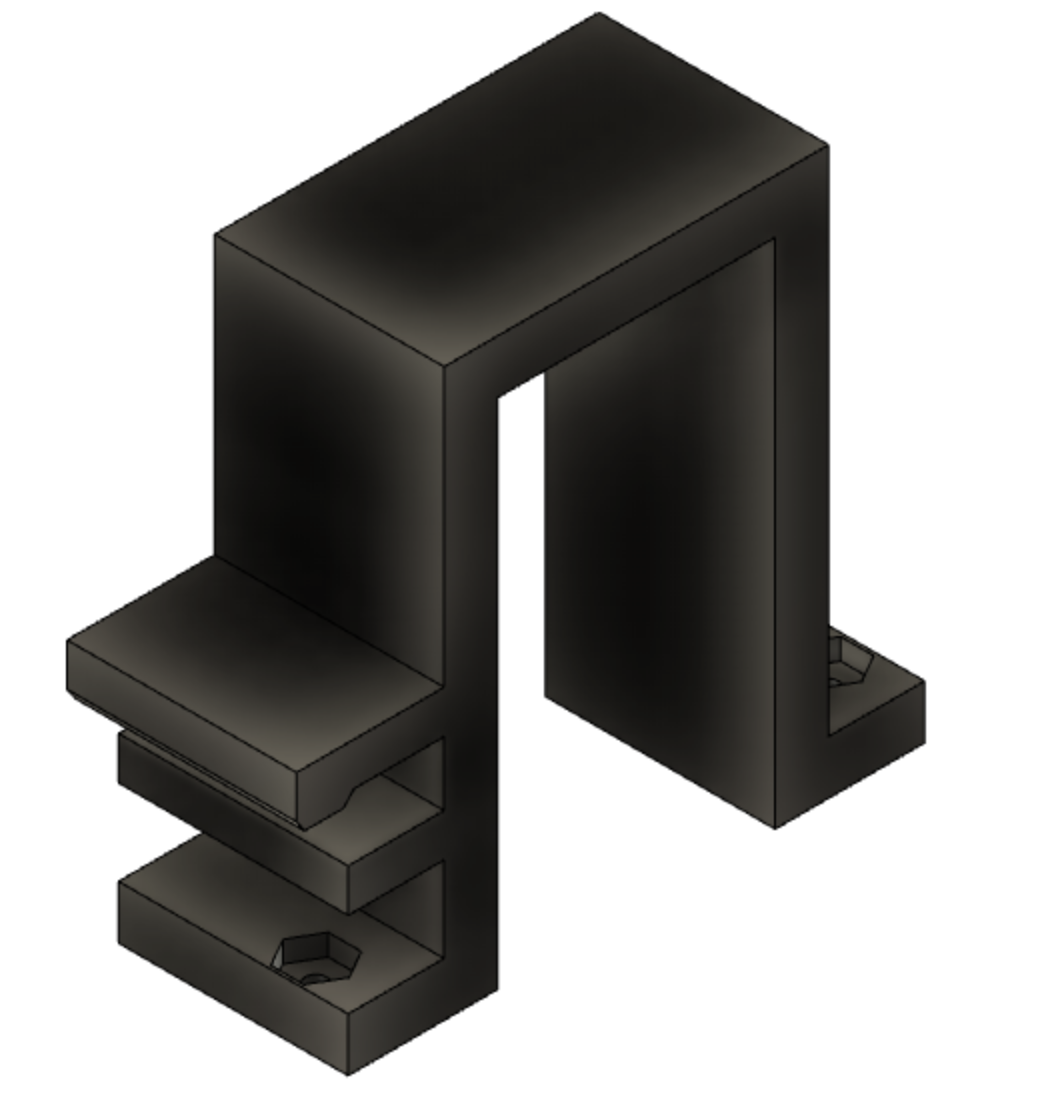
Le servomoteur d'origine était trop souple et introduisait du jeu via un sauve-servo plastique. Nous avons choisi d'installer un Dynamixel AX-12 : contrôle UART, protection couple (sauve-servo électronique), couple élevé. Un support spécifique a été conçu et imprimé en 3D.
Changement de la direction
Un kit drift a été testé pour augmenter l'angle de braquage, mais il supprimait la transmission 4x4 avant et rendait la voiture incontrôlable. Nous avons combiné un kit drift avec un kit direction aluminium afin d'obtenir un meilleur compromis robustesse/angle de braquage.
Fixations du lidar et du Raspberry Pi
Des supports simples, imprimés en 3D, ont été conçus pour fixer le lidar et le Raspberry Pi.
Contrôle moteur
Le contrôleur est piloté par un signal PWM type servomoteur (période 20 ms, largeur d'impulsion 1–2 ms). 1.5 ms = neutre, >1.5 ms = marche avant, <1.5 ms = frein ou marche arrière.
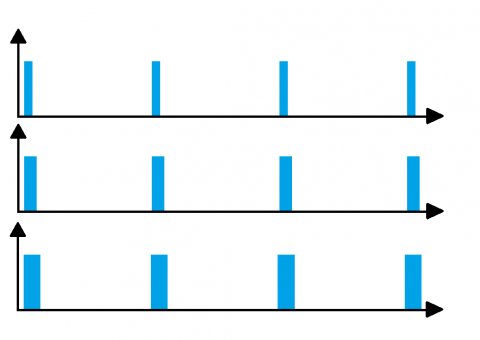
Sur notre moteur, 1.5 ms correspond à 0 V et 2 ms à Vbatterie. La loi de contrôle est proportionnelle.
Frein et Marche arrière
- Depuis neutre (1.5 ms) → <1.5 ms : marche arrière
- Depuis >1.5 ms → <1.5 ms : frein
Algorithme avec temporisation 200 ms entre états :
Ces protocoles sont implémentés sur le STM32F4 pour rendre la gestion de la vitesse transparente pour le Pi (consigne simple).
Odométrie et asservissement
Objectif : asservissement de vitesse pour limiter l'influence de la tension batterie et obtenir des transitions plus vives.
Mesure de la vitesse — Capteur optique
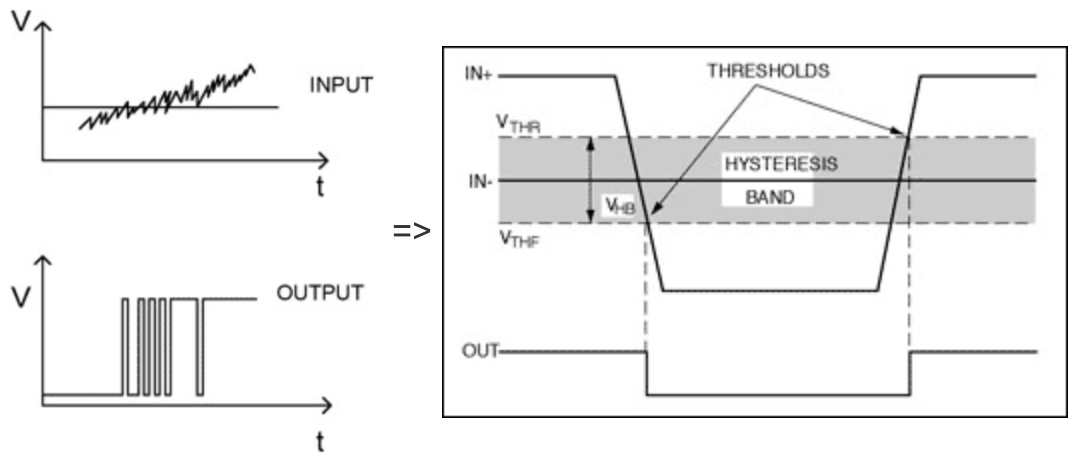
Un capteur optique avec marquage noir/blanc sur l'axe a été testé (interruption par front). Du bruit au seuil (transition noir/blanc) a engendré des faux incréments — une hystérésis via comparateur + DAC interne a été mise en place mais la précision est restée insuffisante.
Mesure de la vitesse — Codeur magnétique
Passage à un capteur rotatif à effet Hall (AS5600). Lecture analogique (0–4096) et traitement périodique ; vitesse max mesurée ≈ 7000 rpm.
int imp=0;
int old_hall_value=0;
uint32_t *codeur;

void calcul_distance(){
    int hall_value=(int)*codeur;
    int delta=hall_value-old_hall_value;
    old_hall_value=hall_value;

    if(abs(delta)<2048){
        imp-=delta;
    }else if(delta>0){
        imp+=-4096+delta;
    }else{
        imp+=4096+delta;
    }
}

/* IRQ toutes les 400us */
void HAL_TIM_PeriodElapsedCallback(TIM_HandleTypeDef *htim)
{
    if (htim == &htim6 )
    {
        calcul_distance();
        if(compteur>=20){ // ~16 ms
            compteur=0;
            asser();    // PID vitesse
        }else{
            compteur++;
        }
    }
}
Asservissement de la vitesse
PID réglé via mesure de période d'oscillation (oscilloscope) et méthode de Ziegler–Nichols.
Asservissement de la direction
Asservissement sur la consigne d'angle de la direction.
Les capteurs utilisés
Le lidar
RPLidar A2 insuffisant (fréquence/résolution). Passage au Hokuyo UBG04-LX : 36 Hz, 1024 points/tour, portée 5.8 m.
Capteurs infrarouges Sharp
Lidar 240° → ajout de Sharp GP2YA41SK0F (latéraux, 30 cm) et GP2Y0A21YK (arrière, 80 cm). Conversion non linéaire tension→distance :
- Arrière (80 cm) : Distance = 29.988 × Volt−1.173
- Latéraux (30 cm) : Distance = 12.08 × Volt−1.058
float coef_IR[] = {12.08,30,12.08};
float power_IR[] = {-1.058, -1.176, -1.058};
char limit_IR[] = {30, 80, 30};

void capteurs_read(){
    uint32_t distance;
    for (uint8_t i=0;i<3;i++){
        distance=coef_IR[i] * pow((float)(adc_buf[i+1]*3.3)/4096, power_IR[i]);
        distance>limit_IR[i]?distance=255:(distance<1?distance=255:1);
        spi_emit[i]=(uint8_t)distance;
    }
}
Calcul coûteux — exécuté hors interruption (dans le main).
Communication au sein de la voiture
Communication PI ⇄ STM32
Nucleo L432KC : deux USART (AX-12 + debug) → SPI entre Pi (maître) et STM32 (esclave) via DMA circulaire. Trames 3 octets :
PI → STM32
| Octet 0 | Octet 1 | Octet 2 |
|---|---|---|
| 0xA2 (ID) | Angle servo (°) | Vitesse (127 = 1.5ms) |
STM32 → PI
| AR Gauche | AR Centre | AR Droit |
|---|---|---|
| distance | distance | distance |
// Réception/émission DMA circulaire (3 octets)
HAL_SPI_TransmitReceive_DMA(&hspi1, spi_emit, spi_recep, 3);
Carte d'interconnexion simple (2 couches, THT, JST-XH) pour brancher Pi, capteurs, I2C, etc.
Gestion du Lidar
Lidar Hokuyo en USB sur le Pi. Librairie Python Hokuyo, adaptation pour obtenir un tableau angle/distance (0–360°), valeurs <20 mm remises à 5.8 m.
def array_scan(self):  # dict va de 119 a -119
    angle=list(self.scan.keys()); distance=list(self.scan.values())
    angle.reverse(); distance.reverse()

    self.scan_array[self.taille_full_2-self.taille_2:self.taille_full_2 , 1] = angle[:self.taille_2]
    self.scan_array[self.taille_full_2:self.taille_full_2+self.taille_2 , 1] = angle[self.taille_2:]
    self.scan_array[self.taille_full_2-self.taille_2:self.taille_full_2 , 0] = distance[:self.taille_2]
    self.scan_array[self.taille_full_2:self.taille_full_2+self.taille_2 , 0] = distance[self.taille_2:]

    self.scan_array[self.scan_array[:,0]<20,0]= 5800
Communication avec l'extérieur
Script Python côté PC : détection IP, déploiement code via SSH, sockets (log + keep-alive), lancement, capture des print(), ordre de départ. Coupure automatique si keep-alive perdu.
def init_socket(self, port):
    s=socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    s.settimeout(10)
    s.setsockopt(socket.SOL_SOCKET,socket.SO_REUSEADDR,1)
    s.bind(('0.0.0.0', port)); s.listen()
    client, address = s.accept(); client.settimeout(1)
    return s, client

def test_com(self):
    while self.on:
        try:
            message = self.socket2.recv(4096).decode()
        except socket.timeout:
            message = 0
        if message != 'op':
            print("A bientôt dans le metro")
            self.voiture.stop(); self.lidar.stop(); self.stop()
Multithreading
import threading, time
class Example:
    def __init__(self):
        self.thread = threading.Thread(target=self.loop); self.thread.start()
    def loop(self):
        while True:
            # tâches périodiques (STM32, lidar, watchdog)
            time.sleep(0.00001)
Tâches multi-threads : consignes STM32, gestion lidar, test de com PC.
Prise de décision par apprentissage par renforcement
Mise en place d'une solution de prise de décision par apprentissage par renforcement.
Qu'est-ce que l'apprentissage par renforcement ?
Environnement (état et), interpréteur → observation st, action at, récompense rt. Objectif : politique maximisant la récompense cumulée (pondérée par γ).
Q-learning : tableau Q(s,a) (mémoire O(|S|·|A|)). Remplissage via stratégie ε-gloutonne (exploitation/exploration).
Modélisation du problème
État physique idéal (x, y, θ, ẋ, ẏ, θ̇) impraticable. Utilisation du lidar : vecteur observation Lt (Nl mesures 0–5 m) et actions Ct(vitesse, braquage ∈ [−1,1]). Espaces continus → problématique de taille pour Q.
Quantification / Réseau de neurones
Discrétisation grossière ou approximation de Q par réseau de neurones (universel sur compacts). Possibilité d'inclure mémoire courte via[Lt, Lt - 1, Ct, Ct - 1].
Framework TensorFlow
Utilisation de TF-Agents (politique π distributionnelle), interface GYM (action/observation spec, step/reset).
,--------------------------------------------------.
|GYM_env                                           |
|--------------------------------------------------|
|+ action_space                                    |
|+ observation_space                               |
|+ step(action) -> observation, reward, done, info |
|+ reset() -> observation, reward, done, info      |
`--------------------------------------------------'
Boucle d'apprentissage
- Apprentissage différé via buffer de transitions
- Sur-apprentissage → plusieurs circuits / validation croisée
Implémentation
Simulateur Python & interface TF-Agents
Environnement PyEnvironment : _reset(), _step(),action_spec, observation_spec.
Boucle d'apprentissage TensorFlow
# Extrait (TF-Agents ReinforceAgent, replay buffer, evaluation)
num_iterations = 100000
collect_episodes_per_iteration = 3
replay_buffer_capacity = 2000
fc_layer_params = (30, 15)
learning_rate = 1e-3
# ... création envs / ActorDistributionNetwork / ReinforceAgent / buffer ...
# boucle: collect_episode -> agent.train(experience) -> eval -> save
Récompense
- Faible récompense pour avancer droit
- Récompense importante au passage de portes
- Pénalités : marche arrière, contact mur
- Épisode borné (60 s) ou collision
Résultat
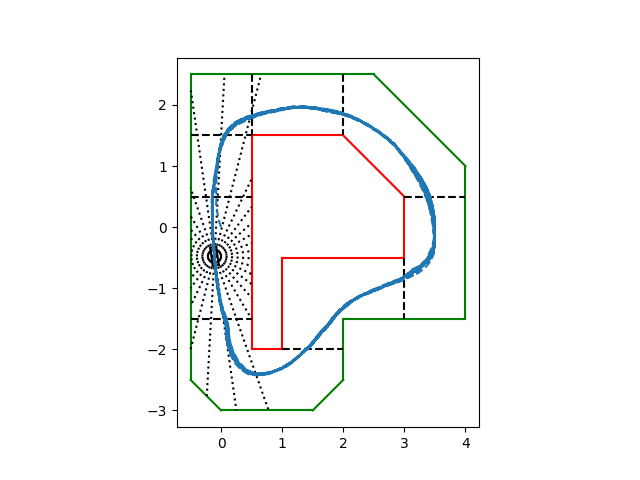
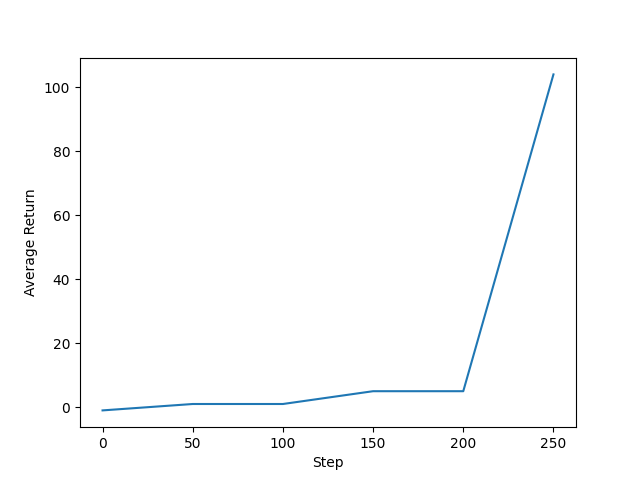
Simulation sur Webots
Contrôleur controleur_alpha.py, interface GYM via DeepBots — compatibilité avec la boucle d'apprentissage précédente.
Voiture réelle
Déploiement visé via policy_saver. TensorFlow non installé avec succès sur Pi 4 malgré builds précompilés. Un moduleinterface_materielle.py a été préparé (observations Lt).
Vision par ordinateur : sens de piste et redémarrage
Détection du sens de la piste et sens de redémarrage (après contact mur) — exploration de deux caméras : Pixy2 (traitement embarqué) et Raspberry Pi Camera V2 (OpenCV).
Travail sur la caméra Pixy2
Étape d'étalonnage (PixyMon) pour la reconnaissance couleur. Problèmes majeurs : forte dépendance à la luminosité, peu de contrôle sur les sorties, et détection imparfaite du vert/rouge (teintes extrêmes).
Caméra V2 Raspberry Pi
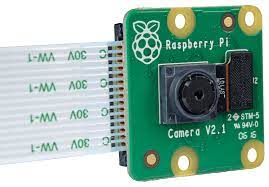
OpenCV, maîtrise des traitements. Détermination d'une bande utile (ROI bas de l'image). Comptage pixels verts/rouges et barycentres — mais vert clair parfois perçu comme gris.
Méthode K-means
Clustering des pixels (k=4/5), passage en HSV pour classer les clusters (rouge, vert, sol), puis barycentres pour le sens de piste.
Pourquoi HSV
Décomposition teinte/saturation/valeur : plus simple de filtrer sur la teinte (H) que sur RGB simultanément.
Traitement en continu
| Méthode | Avantages | Inconvénients |
|---|---|---|
| Vidéo | Continu | Plus lourd en calcul |
| Photos périodiques | Beaucoup plus léger | Tempo (1 s) entre captures |
def camera_stream():
while True:
    camera.capture('image.jpg')
    image = cv2.imread("image.jpg")
    sens = sens_detect(image)
    sleep(1)
Repartir après un contact mur
Capture, passage en HSV, moyenne de H (rouge normalisé 0–20) → choix gauche/droite.
def arret_mur_repartir(frame):
image_hsv = cv2.cvtColor(frame, cv2.COLOR_BGR2HSV)
h,s,v = cv2.split(image_hsv)
h[h>160] = 180 - h[h>160]
moyenne = h.mean()
if 0 < moyenne < 30:
    turn_right = True   # mur rouge
else:
    turn_right = False  # mur vert
return turn_right
Stratégie de course et simulation
Création d'un simulateur
Création d'un simulateur pour élaborer la stratégie de course et servir d'environnement d'apprentissage par renforcement. Le simulateur doit être le plus réaliste possible afin de faciliter le transfert vers la réalité (sim-to-real), voir [1].
Choix de l'environnement de simulation
Webots a été retenu car il dispose d'un moteur physique fiable, de modèles de robots et de capteurs prêts à l'emploi (plusieurs lidars, caméra) et permet de programmer en C++, Java, Python, MATLAB. La documentation est fournie et accélère le développement.
Choix du modèle de voiture
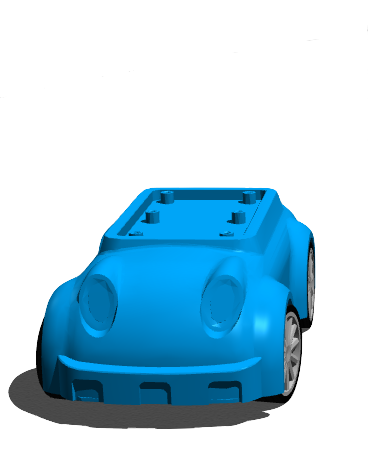
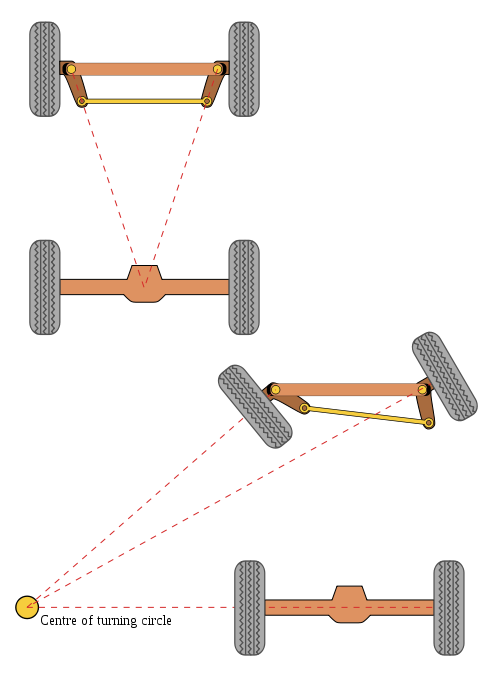
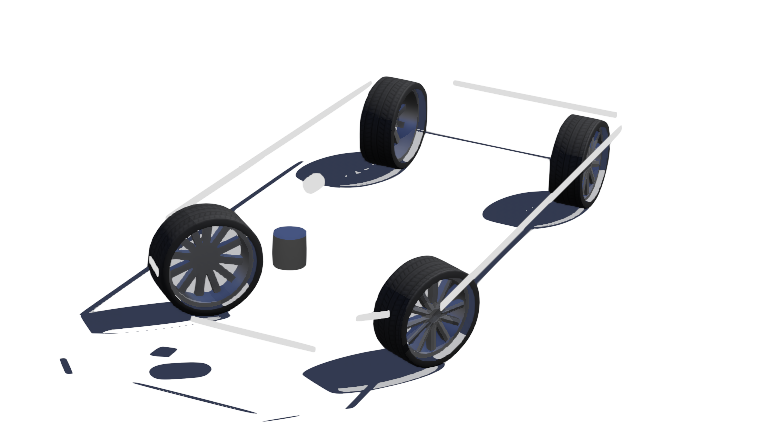
Webots propose des modèles taille réelle, mais pour réduire l'écart d'échelle et améliorer le transfert, le modèle ALTINO (~30 cm) a été choisi. Sa dynamique est basée sur l'Ackermann, ce qui permet de calculer l'angle de braquage de chaque roue.
Réalisation de circuits sur simulateur
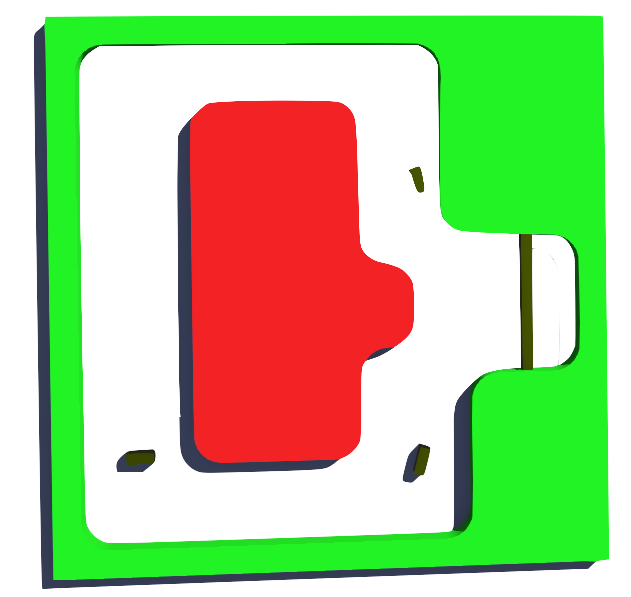
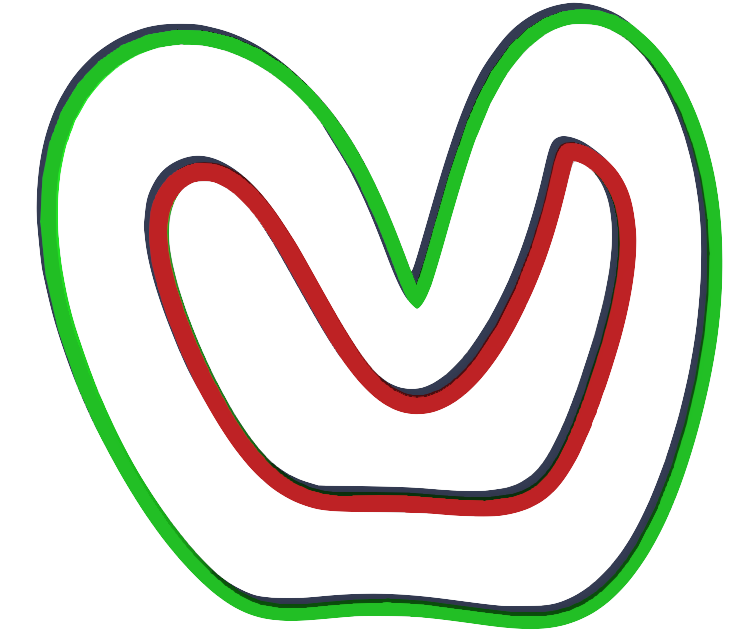
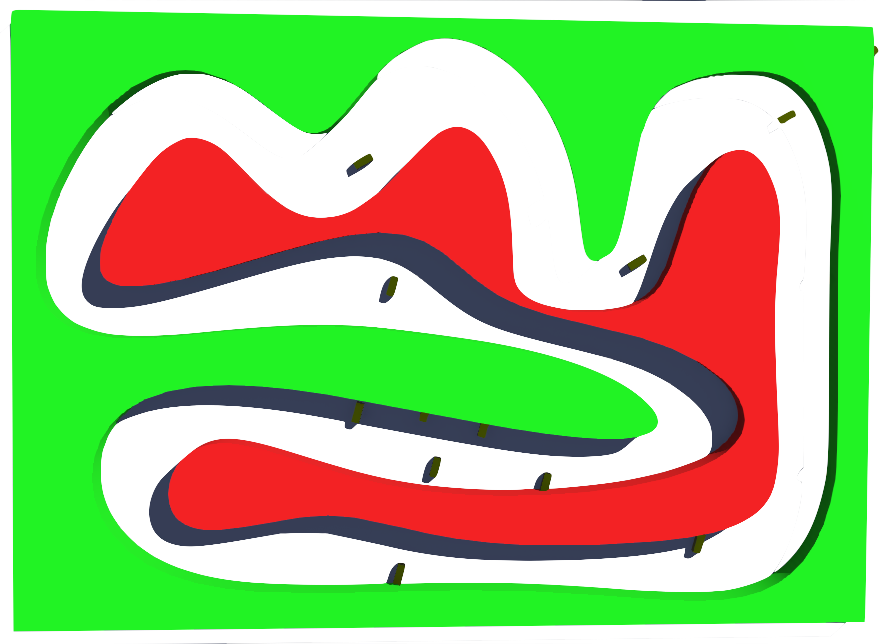
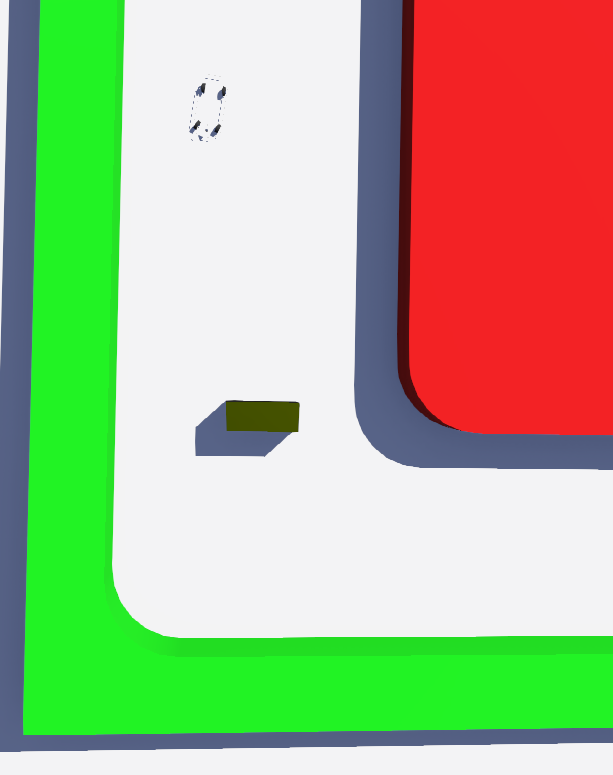
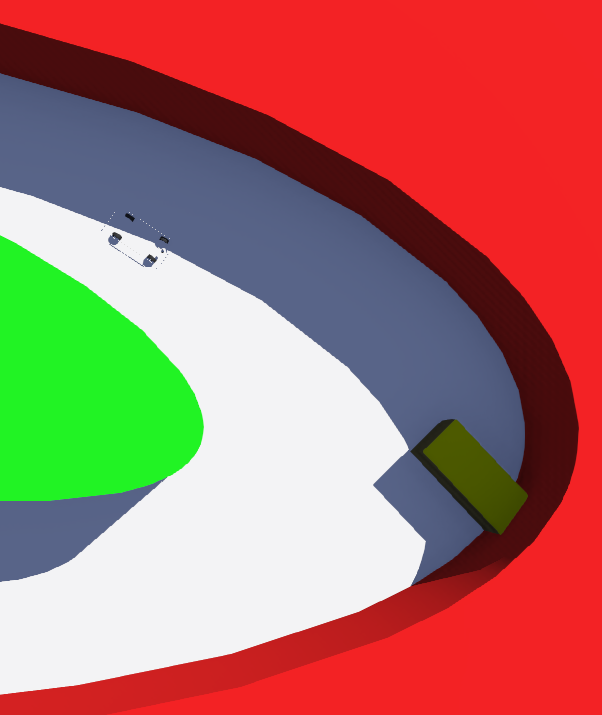
Circuits réalisés sous Fusion360 et obstacles ajoutés dans Webots. La difficulté est croissante afin d'entraîner sur des configurations variées, voir [2].
Stratégie de course
Commande par 2 paramètres : vitesse et angle de braquage.
Consigne de vitesse
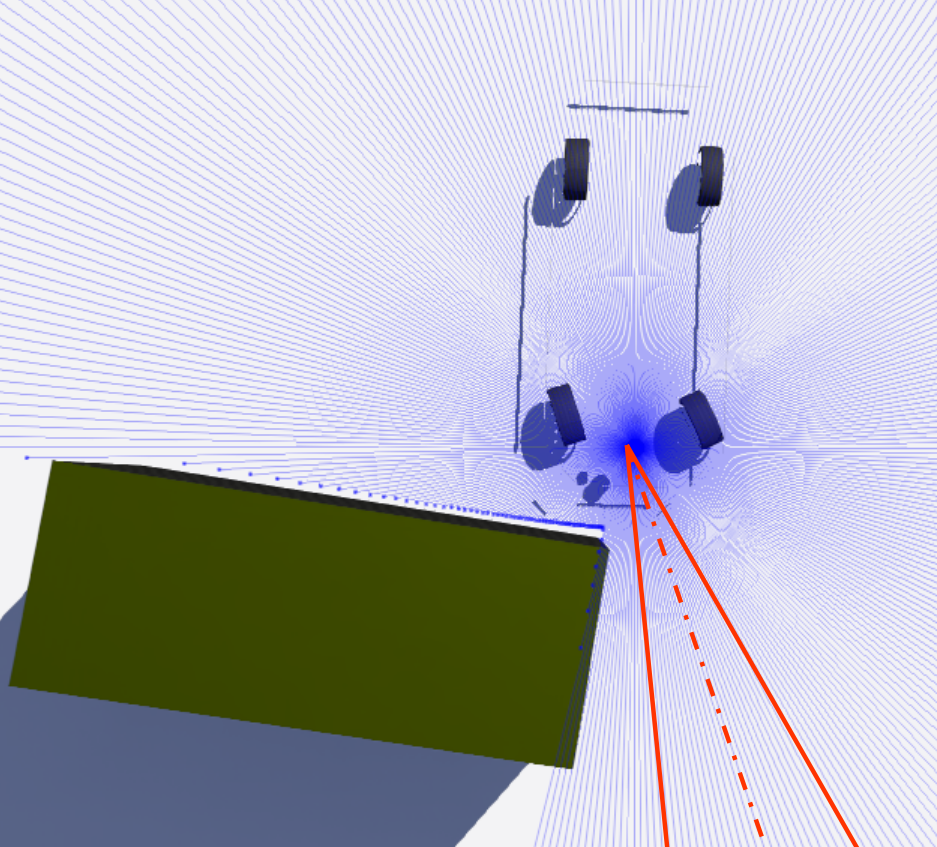
La vitesse dépend de la distance libre à l'avant. Utiliser un seul rayon directement devant provoque des effets de tout-ou-rien dès qu'un obstacle est légèrement désaxé.
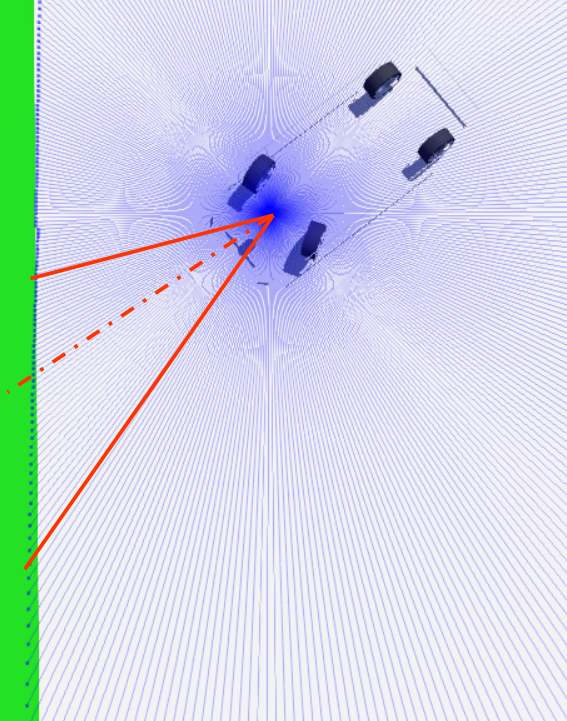
On moyenne donc les distances dans une ouverture angulaire alignée avec les roues. Cela améliore la robustesse mais ne tient pas compte des obstacles très proches mais désaxés.
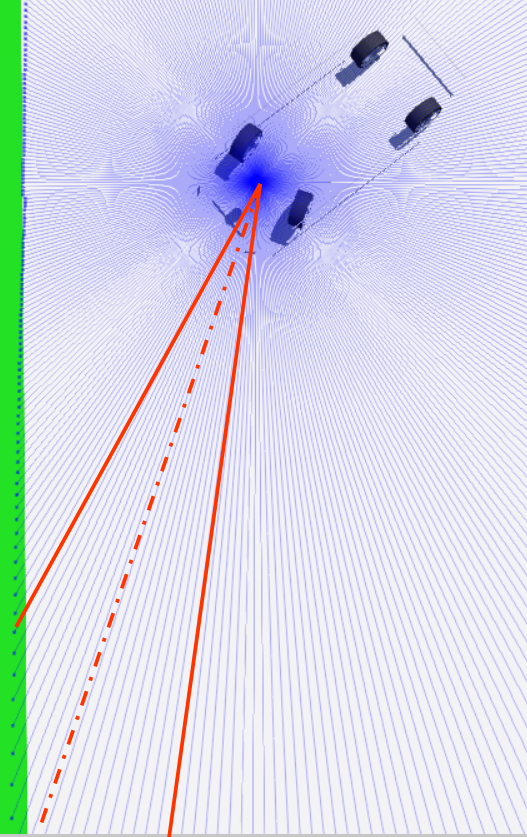
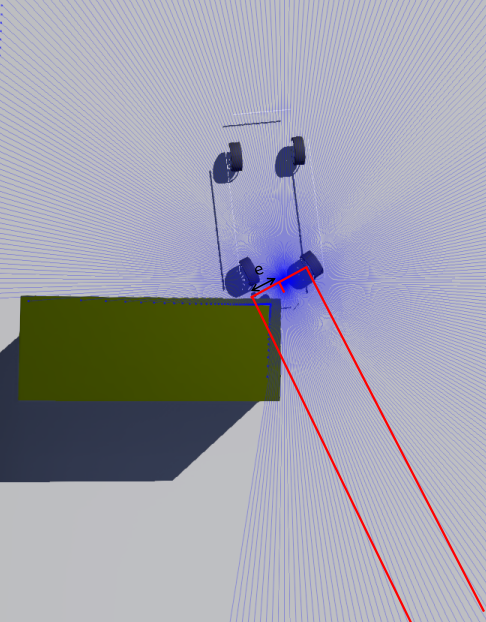
Pour pallier cela, on remplace le cône par un tube d'épaisseur 2ealigné avec les roues : un rayon est retenu s'il respecte r < e / cos(θ−α). Ainsi, les obstacles proches sont correctement pris en compte.
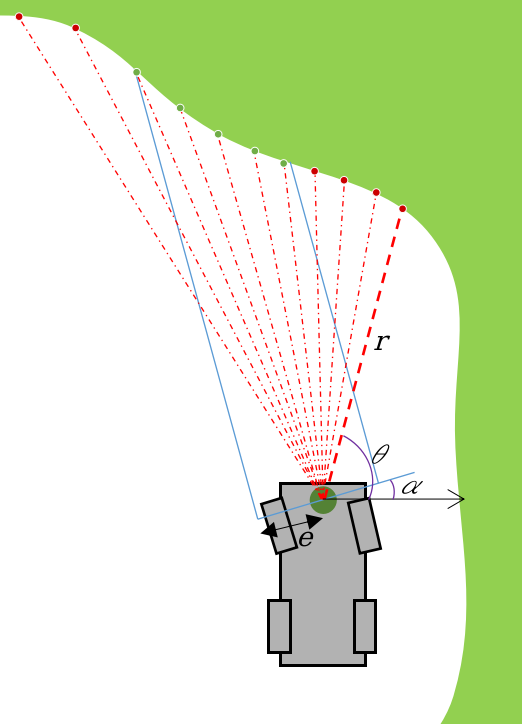
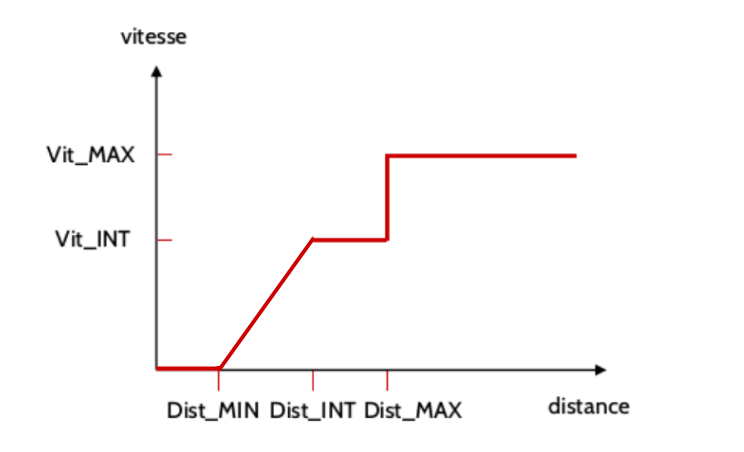
La vitesse est ensuite calculée à partir du plus petit rayon valide via une loi paramétrable (Dist_MIN/Dist_MAX/Vit_MAX) afin d'assurer l'arrêt à proximité d'un obstacle et des vitesses élevées lorsque la voie est libre.
Consigne d'angle (méthode des rayons)
Somme des distances quart avant gauche vs droite → erreur → PID direction. Limites sur épingles et obstacles → détections dédiées.
Détection d'épingles et d'obstacles
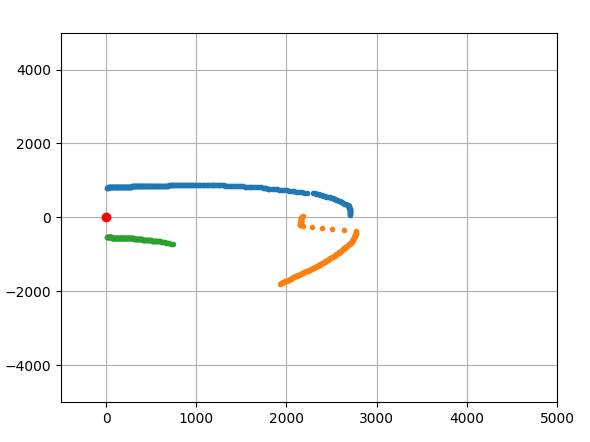
Clustering des points lidar via un seuil de discontinuité entre points adjacents. Deux points trop éloignés sont séparés en clusters distincts.
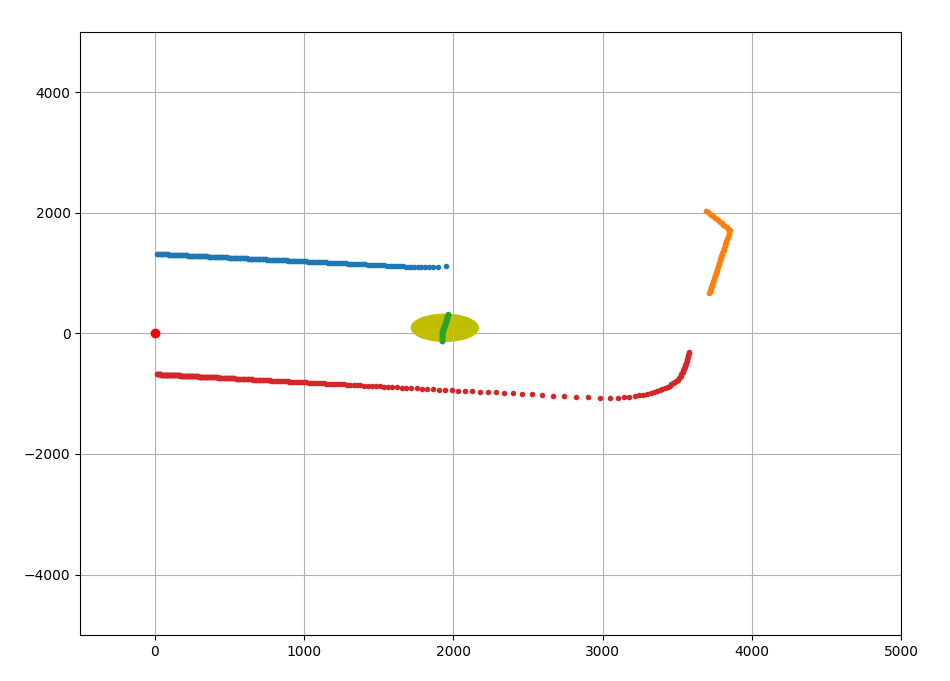
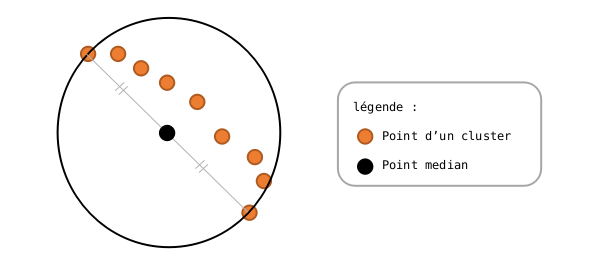
Détection d'obstacles : pour chaque cluster, on définit un cercle de diamètre reliant les extrémités et on calcule une densité (surface/nb de points). Au-delà d'un seuil, le cluster est considéré comme un obstacle (petit, dense), tandis que les murs sont vastes et peu denses.
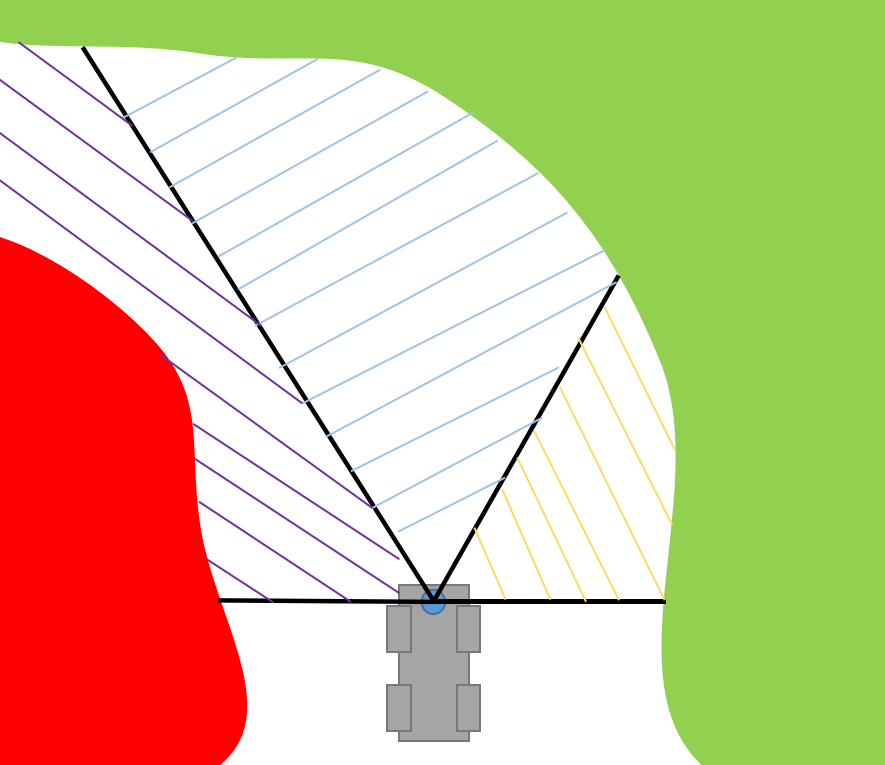
Détection d'épingles : définition de trois zones (Est, Nord, Ouest) et calcul des proportions de points par cluster dans ces zones. Une épingle est détectée si le cluster dominant en zone Nord possède aussi au moins 70% des points en Ouest et 20% en Est (droite inversée pour épingle à droite).
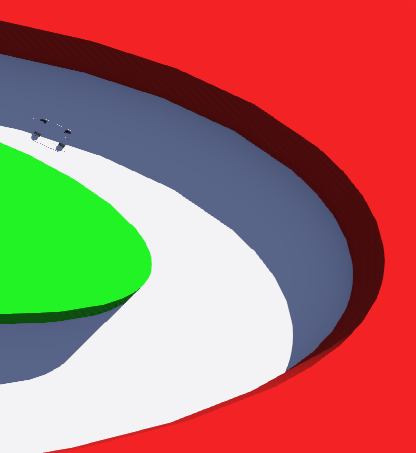
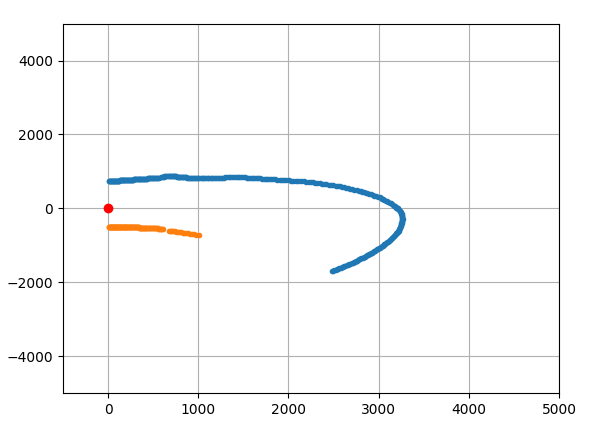
Robustification en présence d'obstacles dans une épingle : si un obstacle casse un mur en deux, on fusionne obstacle+précédent+suivant si les gaps sont inférieurs à un seuil, puis on réévalue les critères.
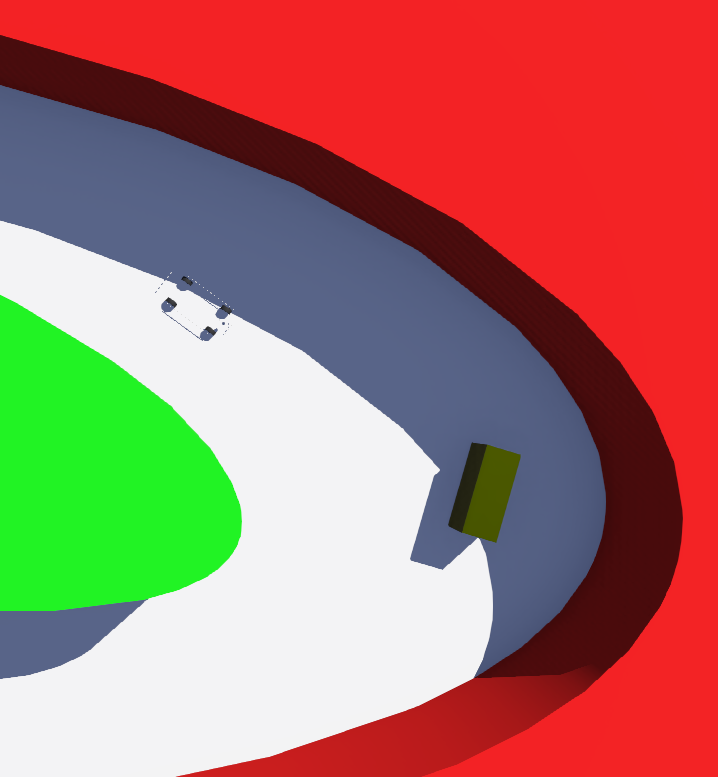
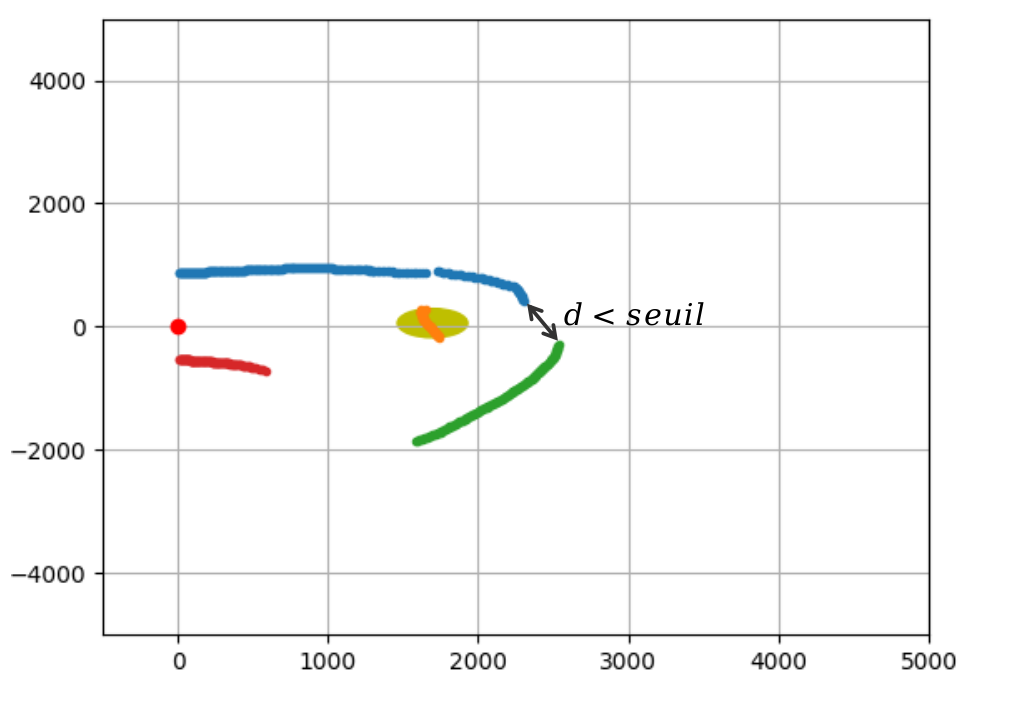
Limites : si un obstacle colle un mur, la détection peut échouer. Un second mécanisme fusionne des clusters voisins non obstacles lorsque l'écart est sous seuil pour rétablir la continuité du mur.
Stratégie d'évitement d'obstacle
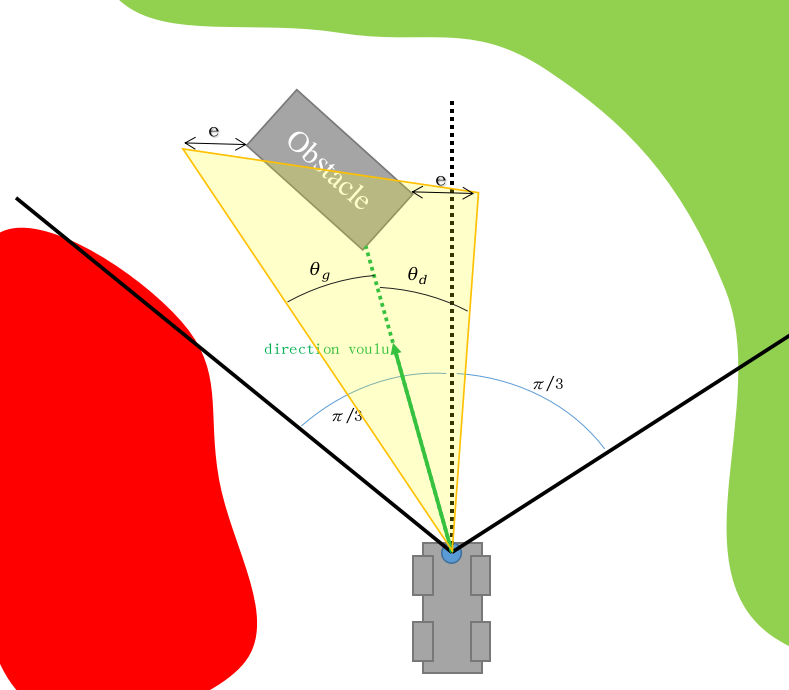
Un obstacle est considéré s'il se trouve dans un arc de 2π/3à l'avant, à moins de 3 m. Si la direction désirée pointe vers l'obstacle (tolérancee), on calcule les angles libres gauche/droite et on choisit le plus sûr. Pour éviter les impasses quand l'obstacle colle un mur, on vise le côté offrant la plus grande marge, puis le point médian obstacle–mur lorsque l'obstacle est à moins de 1.5 m.
Stratégie en cas d'épingle
En cas d'épingle détectée, braquage maximal du bon côté sauf obstacle. Un contrôle de la distance intérieure empêche les chocs: si une distance intérieure passe sous un seuil, la consigne d'angle est ramenée pour aller droit.
Conclusion générale
Projet concret guidé par la course. Répartition des domaines (mécatronique, vision, stratégie, RL) et intégration. Sim-to-real variable selon modules (épingle ok, évitement d'obstacle plus délicat). IA non déployée in-car mais base solide : voiture capable de tourner vite sur circuits variés. Suites : améliorer l'évitement et implémenter l'IA à bord.
Références
- Wenshuai Zhao, Jorge Peña Queralta, Tomi Westerlund (2020).
Sim-to-Real Transfer in Deep Reinforcement Learning for Robotics: a Survey - Thomas Chaffre, Julien Moras, Adrien Chan-Hon-Tong, Julien Marzat (2020).
Sim-to-Real Transfer with Incremental Environment Complexity for Reinforcement Learning of Depth-Based Robot Navigation